AWS S3 스토리지 초보자 가이드: 파일 업로드부터 사용법까지
AWS S3 스토리지 초보자 가이드: 파일 업로드부터 사용법까지 모든 과정을 쉽게 따라 할 수 있습니다. 2026년 기준으로 AWS S3는 전 세계 수많은 기업이 사용하는 안정적인 클라우드 스토리지 서비스거든요. 이 글에서는 버킷 생성부터 업로드, 권한 설정, 비용 관리까지 실무에서 자주 쓰는 흐름을 순서대로 정리합니다.
AWS S3 시작하기: 클라우드 스토리지의 기본 개념 이해하기
AWS S3(Simple Storage Service)는 인터넷에 연결된 스토리지 서비스입니다. 원하는 만큼 데이터를 저장하고 언제든 필요한 순간에 접근할 수 있거든요. 2026년 현재 S3는 단순 파일 보관을 넘어 웹 호스팅, 데이터 백업, 빅데이터 분석 등 다양한 용도로 활용되고 있습니다. 처음 접하는 분들도 쉽게 이해할 수 있도록 기본 개념부터 알려드립니다.
S3 버킷(Bucket)은 무엇이며 어떻게 작동하나요?
S3 버킷은 데이터를 담는 최상위 컨테이너 역할을 합니다. 마치 컴퓨터의 폴더와 같지만 훨씬 강력한 기능들을 제공하거든요. 전 세계적으로 유일한 이름을 가져야 하고, 버킷 내부에 여러 폴더(Prefix)와 객체(Object)를 저장할 수 있습니다. AWS Management Console에서 S3 서비스로 이동하면 버킷 생성 화면을 바로 확인할 수 있습니다.
S3 객체(Object)에는 어떤 정보가 담겨 있나요?
S3 객체는 버킷에 저장되는 모든 종류의 파일입니다. 이미지, 동영상, 문서 파일 등 어떤 데이터든 객체가 될 수 있거든요. 각 객체는 고유한 키(Key)를 가지고 있으며, 데이터 자체 외에도 메타데이터(Metadata)를 포함합니다. 예를 들어 ‘profile.jpg’ 파일은 객체로 저장되고, 파일 크기나 마지막 수정일 같은 메타데이터가 함께 관리됩니다. AWS 공식 문서(docs.aws.amazon.com)에서 객체 구성에 대한 더 자세한 내용을 찾아볼 수 있습니다.
AWS S3 버킷 생성하는 방법: 첫 단계 시작하기
S3를 사용하려면 가장 먼저 버킷을 생성해야 합니다. 이 과정은 몇 분 안에 완료되며, 앞으로 데이터를 저장할 공간을 마련하는 핵심 단계거든요. 버킷 설정은 한 번만 잘 해두면 이후 운영에 큰 도움이 됩니다. 버킷 이름·리전·퍼블릭 액세스 차단 여부처럼 나중에 바꾸기 번거로운 항목이 있어 처음 설정할 때 신경 써야 합니다.
S3 버킷 이름은 어떻게 정해야 하나요?
S3 버킷 이름은 전 세계적으로 유일해야 합니다. 소문자로 시작하고 3~63자 사이여야 하며, 하이픈(-)과 점(.)만 허용됩니다. 예를 들어 ‘my-project-images-2026’처럼 프로젝트 이름과 용도, 연도를 함께 표기하면 좋습니다. 이미 다른 계정에서 사용 중인 이름은 쓸 수 없으므로, 프로젝트명·용도·연도를 조합해 고유하고 의미 있는 이름을 선택하는 것이 중요합니다.
리전(Region) 선택이 왜 중요한가요?
리전은 버킷이 물리적으로 생성될 데이터 센터의 위치를 의미합니다. 사용자와 가까운 리전을 선택하면 데이터 전송 속도를 높일 수 있거든요. 한국 사용자 대상 서비스라면 ‘ap-northeast-2(서울)’ 리전을 선택하는 것이 일반적입니다. 데이터 주권이나 규제 준수 측면에서도 리전 선택은 매우 중요한 요소입니다. AWS Global Infrastructure(aws.amazon.com/ko/about-aws/global-infrastructure) 페이지에서 각 리전의 상세 정보를 확인할 수 있습니다.
버킷 생성 시 어떤 설정을 해야 하나요?
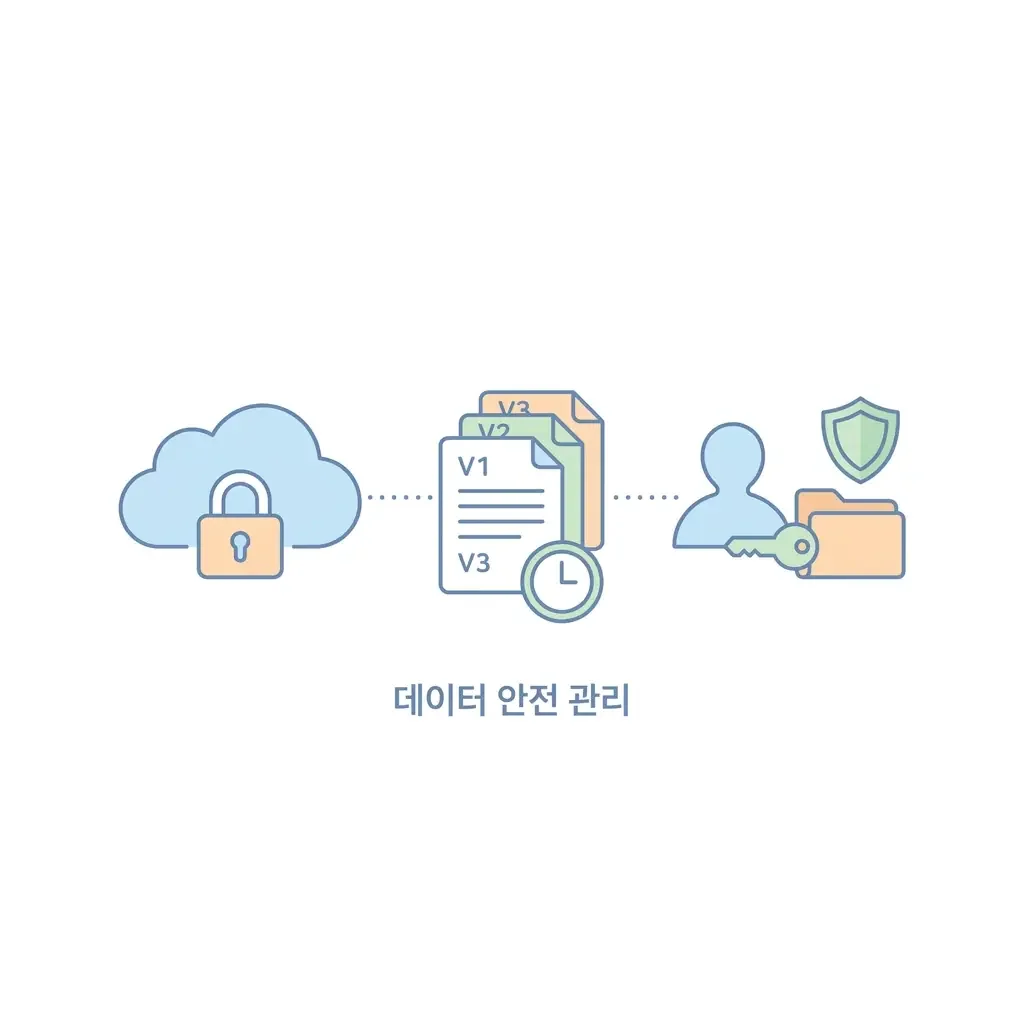
버킷 생성 시 ‘모든 퍼블릭 액세스 차단’ 설정은 기본적으로 활성화되어 있습니다. 특별한 이유가 없다면 이 설정을 유지하는 것이 보안에 유리하거든요. 정적 웹사이트 호스팅처럼 퍼블릭 액세스가 필요한 경우에만 해당 설정을 해제해야 합니다. 또한, ‘버전 관리’ 기능은 실수로 파일이 삭제되거나 덮어쓰여도 이전 버전으로 복구할 수 있어 매우 유용합니다.
AWS S3에 파일 업로드하는 방법: 데이터 저장의 시작
버킷을 성공적으로 생성했다면 이제 데이터를 업로드할 차례입니다. S3 콘솔을 이용하는 방법부터 프로그래밍 방식으로 업로드하는 방법까지 다양하거든요. 초보자라면 AWS Management Console을 통해 직접 업로드하는 것이 가장 직관적입니다.
AWS 콘솔을 이용해 파일을 업로드하는 과정은 어떻게 되나요?
AWS S3 콘솔에 접속하여 원하는 버킷을 선택합니다. 그 다음 ‘업로드’ 버튼을 클릭하고, 파일 탐색기에서 원하는 파일을 선택하면 됩니다. 드래그 앤 드롭 방식으로도 쉽게 업로드할 수 있거든요. 여러 파일을 한 번에 올릴 때는 폴더 단위로 압축해서 업로드한 뒤 필요 시 S3 안에서 압축을 해제하는 방식도 쓸 수 있습니다. 업로드 속도는 파일 크기와 인터넷 환경에 따라 달라집니다.
파일 업로드 시 접근 권한을 설정하는 방법은 무엇인가요?
파일 업로드 시 각 객체에 대한 접근 권한을 설정할 수 있습니다. 기본적으로 버킷 정책을 따르지만, 개별 객체에 대한 ACL(Access Control List)을 통해 세부적으로 조정 가능하거든요. 예를 들어, 특정 이미지는 웹사이트에서 바로 접근 가능하도록 ‘Public’으로 설정하고, 중요한 문서는 특정 사용자만 접근할 수 있도록 ‘Private’으로 유지할 수 있습니다. AWS Identity and Access Management(IAM) 서비스와 연동하여 세밀한 권한 제어가 가능합니다.
대량의 파일을 효율적으로 업로드하는 팁이 있나요?
대량의 파일을 업로드할 때는 AWS CLI(Command Line Interface)나 SDK(Software Development Kit)를 활용하는 것이 훨씬 효율적입니다. CLI를 사용하면 터미널 명령 한 줄로 수백, 수천 개의 파일을 동기화하거나 업로드할 수 있거든요. 예를 들어 `aws s3 cp 로컬 경로 s3://버킷 이름/S3 경로 –recursive` 명령어를 사용하면 로컬 폴더 전체를 S3에 복사할 수 있습니다. 대용량 데이터를 업로드할 때는 콘솔보다 CLI 쪽이 훨씬 빠르고 안정적입니다.
AWS S3 파일 관리 및 접근 제어 설정하기
S3에 저장된 파일들을 효율적으로 관리하고 보안을 유지하는 것은 매우 중요합니다. 단순한 업로드를 넘어 객체 버전 관리, 수명 주기 정책, 그리고 접근 제어 설정을 통해 데이터를 안전하게 지킬 수 있거든요.
S3 객체 버전 관리는 왜 필요한가요?
객체 버전 관리는 버킷 내의 모든 객체에 대해 여러 버전을 유지하는 기능입니다. 파일이 실수로 삭제되거나 덮어쓰여도 이전 버전으로 쉽게 복구할 수 있거든요. 실수로 파일을 덮어쓰거나 삭제했을 때 버전 관리가 활성화되어 있으면 이전 버전으로 빠르게 복구할 수 있습니다. 이 기능은 버킷 속성에서 한 번 활성화하면 이후 업로드되는 모든 객체에 자동으로 적용됩니다.
S3 수명 주기 정책으로 비용을 절감하는 방법이 있나요?
수명 주기 정책은 객체의 저장 기간이나 스토리지 클래스를 자동으로 관리하는 기능입니다. 예를 들어, 30일이 지난 객체는 비용이 저렴한 ‘Glacier’ 스토리지 클래스로 자동으로 이동시키거나 90일이 지나면 영구적으로 삭제하도록 설정할 수 있거든요. 사용 빈도가 낮은 백업 데이터를 일정 기간 후 자동으로 아카이브 스토리지로 이동시키도록 설정해두면 스토리지 비용을 줄일 수 있습니다.
버킷 및 객체에 대한 접근 권한은 어떻게 제어하나요?
접근 권한 제어는 크게 버킷 정책(Bucket Policy)과 IAM(Identity and Access Management) 정책을 통해 이루어집니다. 버킷 정책은 특정 버킷에 대한 전반적인 접근 규칙을 정의하고, IAM 정책은 AWS 사용자나 역할에 S3 자원에 대한 접근 권한을 부여합니다. 예를 들어, 특정 IP 주소에서만 버킷에 접근하도록 허용하거나, 특정 사용자만 파일을 삭제할 수 있도록 제한할 수 있습니다. 예를 들어 웹 서버의 IP 주소에서만 파일 다운로드를 허용하도록 버킷 정책을 설정하면 보안을 강화할 수 있습니다.
AWS S3 비용 효율적으로 사용하는 꿀팁
S3는 사용한 만큼만 비용을 지불하는 구조라 초기 비용 부담이 적지만, 예상치 못한 비용이 발생할 수도 있습니다. 스토리지 클래스 선택, 데이터 전송량 관리, 그리고 모니터링을 통해 비용을 효율적으로 관리할 수 있거든요.
S3 스토리지 클래스는 어떤 기준으로 선택해야 하나요?
S3는 다양한 스토리지 클래스를 제공하며, 각각 저장 비용과 데이터 검색 속도, 그리고 가용성이 다릅니다. 자주 접근하는 데이터는 ‘Standard’를, 자주 접근하지 않지만 즉시 접근이 필요한 데이터는 ‘Standard-IA(Infrequent Access)’를, 장기 보관용 백업 데이터는 ‘Glacier’를 선택하는 것이 좋습니다. 자주 접근하지 않는 백업 데이터를 Standard 대신 Glacier로 옥기면 저장 비용을 큼 폭으로 줄일 수 있습니다. 스토리지 클래스별 요금은 AWS S3 가격 페이지(aws.amazon.com/ko/s3/pricing)에서 자세히 확인할 수 있습니다.
데이터 전송(Data Transfer) 비용을 줄이는 방법이 있나요?
S3는 저장된 데이터를 AWS 외부로 전송할 때 비용이 발생합니다. 이를 ‘데이터 전송 아웃(Data Transfer Out)’이라고 하거든요. CloudFront 같은 CDN(Contents Delivery Network) 서비스를 함께 사용하면 데이터 전송 비용을 크게 절감할 수 있습니다. CloudFront는 데이터를 사용자에게 더 가까운 엣지 로케이션에 캐싱하여 S3에서 직접 데이터를 전송하는 양을 줄여주거든요. CloudFront를 함께 쓰면 데이터 전송 비용을 줄일 수 있는데, 절감 폭은 트래픽 패턴과 캐싱 효율에 따라 크게 달라집니다.
S3 비용을 모니터링하고 알림을 설정하는 방법은 무엇인가요?
AWS Cost Explorer를 통해 S3 사용량과 예상 비용을 주기적으로 확인할 수 있습니다. 또한, AWS Budgets 서비스를 활용하여 특정 임계값을 초과할 경우 이메일이나 SMS로 알림을 받을 수 있거든요. 월별 예상 비용이 일정 비율(예: 80%)에 도달하면 알림이 오도록 설정해두면 유용합니다. 이렇게 하면 예기치 않은 비용 폭탄을 미리 방지하고 적절한 조치를 취할 수 있습니다.
AWS S3 활용 사례: 실제 서비스에 적용하기
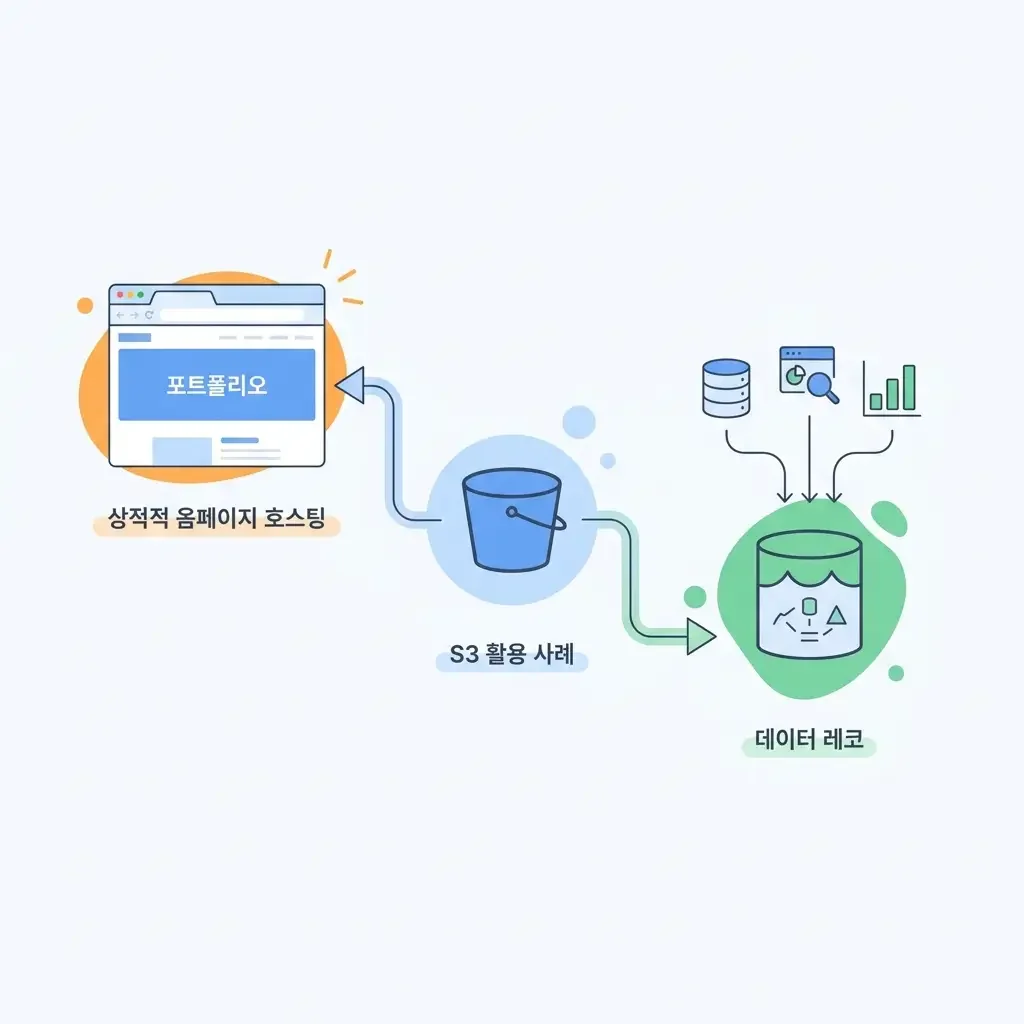
AWS S3는 단순히 파일을 저장하는 것을 넘어 다양한 서비스와 결합하여 강력한 솔루션을 구축할 수 있습니다. 정적 웹사이트 호스팅부터 데이터 레이크 구성까지 활용 범위가 넓거든요. 실제 서비스에 어떻게 적용되는지 몇 가지 예를 들어 설명해 드릴게요.
S3를 이용한 정적 웹사이트 호스팅은 어떻게 하나요?
S3는 HTML, CSS, JavaScript 같은 정적 파일을 호스팅하는 데 최적화되어 있습니다. 별도의 웹 서버를 운영할 필요 없이 S3 버킷 하나로 웹사이트를 운영할 수 있거든요. 버킷 속성에서 ‘정적 웹 사이트 호스팅’을 활성화하고 인덱스 문서와 오류 문서를 지정하면 됩니다. 정적 파일만으로 구성된 사이트는 별도 서버 없이 S3만으로 운영할 수 있어 비용 부담이 매우 적습니다. Route 53과 같은 도메인 서비스와 연동하면 자신만의 도메인으로 접속할 수 있습니다.
S3를 데이터 레이크(Data Lake)로 활용할 수 있나요?
네, S3는 대량의 정형 및 비정형 데이터를 저장하는 데이터 레이크의 핵심 저장소로 널리 사용됩니다. 저렴한 비용으로 무제한에 가까운 스토리지 확장성을 제공하거든요. AWS Glue, Athena, Redshift Spectrum과 같은 다른 서비스들과 연동하여 S3에 저장된 데이터를 분석하고 활용할 수 있습니다. 실제로 많은 기업이 S3를 데이터 레이크의 저장소로 사용해 고객 행동이나 로그를 분석하는 데 활용합니다.
S3를 활용한 백업 및 재해 복구 전략은 무엇인가요?
S3는 기업의 중요한 데이터를 안전하게 백업하고 재해 복구 시스템을 구축하는 데 필수적인 요소입니다. 교차 리전 복제(Cross-Region Replication) 기능을 사용하면 버킷의 데이터를 다른 AWS 리전으로 자동으로 복제하여 재해 상황에도 데이터를 보호할 수 있거든요. AWS Backup 서비스와 연동하면 다양한 AWS 서비스의 백업을 중앙에서 관리할 수 있습니다.
자주 묻는 질문 (FAQ)
AWS S3를 사용하려면 반드시 AWS 계정이 있어야 하나요?
네, AWS S3를 포함한 모든 AWS 서비스를 사용하려면 유효한 AWS 계정이 필요합니다. AWS 공식 웹사이트(aws.amazon.com)에서 무료로 계정을 생성할 수 있거든요. 처음 가입 시 일정 기간 무료 사용량(프리 티어)을 제공합니다.
S3에 저장할 수 있는 파일 크기에 제한이 있나요?
단일 객체는 최대 5TB까지 저장할 수 있습니다. 5GB를 초과하는 대용량 파일의 경우 멀티파트 업로드(Multipart Upload)를 사용하는 것이 좋습니다.
S3는 데이터 보안에 얼마나 안전한가요?
S3는 기본적으로 데이터를 암호화하여 저장하며, 버킷 정책, IAM 정책, ACL 등 다양한 보안 기능을 제공합니다. 또한, S3는 99.999999999%의 객체 내구성을 보장하거든요. AWS Whitepapers(aws.amazon.com/whitepapers)에서 S3 보안에 대한 상세 보고서를 확인할 수 있습니다.
S3 버킷을 삭제하면 안에 있는 파일도 모두 사라지나요?
네, S3 버킷을 삭제하면 해당 버킷 안에 저장된 모든 객체와 버전도 함께 영구적으로 삭제됩니다. 버킷 삭제는 돌이킬 수 없으므로 신중하게 진행해야 하거든요. 중요한 데이터는 삭제 전 반드시 백업해두는 것이 좋습니다.
S3와 AWS EBS(Elastic Block Store)는 어떻게 다른가요?
S3는 객체 스토리지 서비스로, 파일을 URL을 통해 접근하는 방식입니다. 반면 EBS는 블록 스토리지 서비스로, EC2 인스턴스에 직접 연결하여 운영체제의 볼륨처럼 사용할 수 있거든요. S3는 확장성이 뛰어나고 저렴하며, EBS는 특정 서버의 고성능 스토리지가 필요할 때 적합합니다. 2026년 현재 두 서비스는 용도에 따라 선택적으로 활용됩니다.
참고자료
- AWS 공식 문서: AWS S3 시작하기: docs.aws.amazon.com/ko_kr/s3/index.html
- AWS S3 가격 정보: aws.amazon.com/ko/s3/pricing
- AWS Global Infrastructure: aws.amazon.com/ko/about-aws/global-infrastructure